500张支持工单挤向工程师,AI抽检准确率75%却翻出高优先级事故;真正要治的是升级链路失真
支持现场 · 工单分诊
核心判断:工单分诊的目标不是让AI替团队关单,而是让每张请求更快进入正确责任人、带齐复现证据,并把可能影响客户与服务稳定性的信号及时升级。
支持工单 缺陷分流 优先级升级 复现证据 人工接管
支持团队每天收到登录失败、配置疑问、数据异常和功能故障。描述相似的两张工单,背后可能分别是一次操作误解和一个正在扩散的产品缺陷,工程师却常被迫逐张重新判断。
Google Cloud公开案例显示,一家金融犯罪风险技术企业曾用AI处理500多张支持请求,区分普通支持问题与需要工程团队介入的缺陷,抽检分类准确率为75%,还发现了原本应升级为更高优先级事故的请求。
75%意味着系统远没有资格独立决定工单命运,却也揭示出更重要的病灶:人工队列并不天然可靠。只要影响范围、复现条件和升级理由没有结构化记录,高风险信号就可能被埋在先来后到的顺序里。
因此,分诊不能只追求少看几张工单。它应把请求类型、客户影响、证据完整度、置信提示和责任去向放进同一条链路,让AI扩大扫描面,让人守住误分与重大事故的边界。
症状
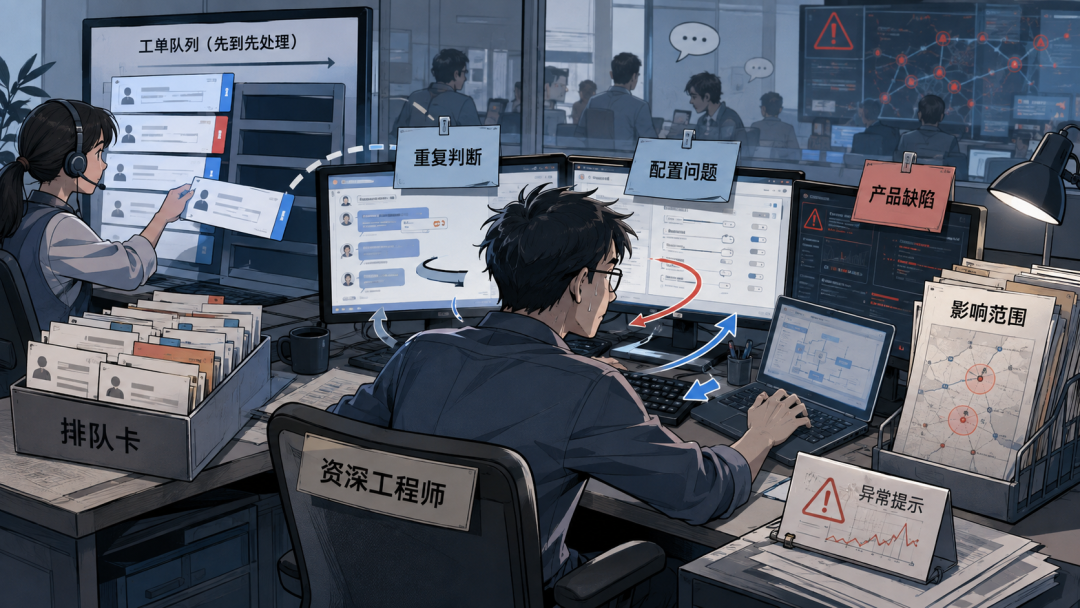
队列看似有序,工程时间却被重复判断切碎
很多团队把支持邮箱或工单系统当成统一入口,却没有统一分诊语言。客服写用户无法使用,工程师仍要追问版本、账户范围、发生时间、错误表现和最近变更,真正排查开始得很晚。
工程团队修复缺陷后,需要回写受影响版本、验证方法和客户通知范围,避免技术完成而支持侧仍不知道如何确认。普通咨询、单客配置、已知问题和新缺陷混在一起时,资深工程师既要处理技术问题,也要承担信息补录和优先级判断。
队列数量没有失控,注意力却被不断切换。优先级规则应由业务影响负责人共同制定,技术严重不等于经营影响,二者需要在事故分级中同时出现。更危险的是,先到先处理会制造一种公平错觉。
影响多个客户但描述不完整的事故,可能排在一张措辞急迫、实际影响有限的咨询之后。入口表单可以根据产品模块动态追问,不必让所有客户填写同一套长问卷,从而兼顾信息完整与提交体验。
字段
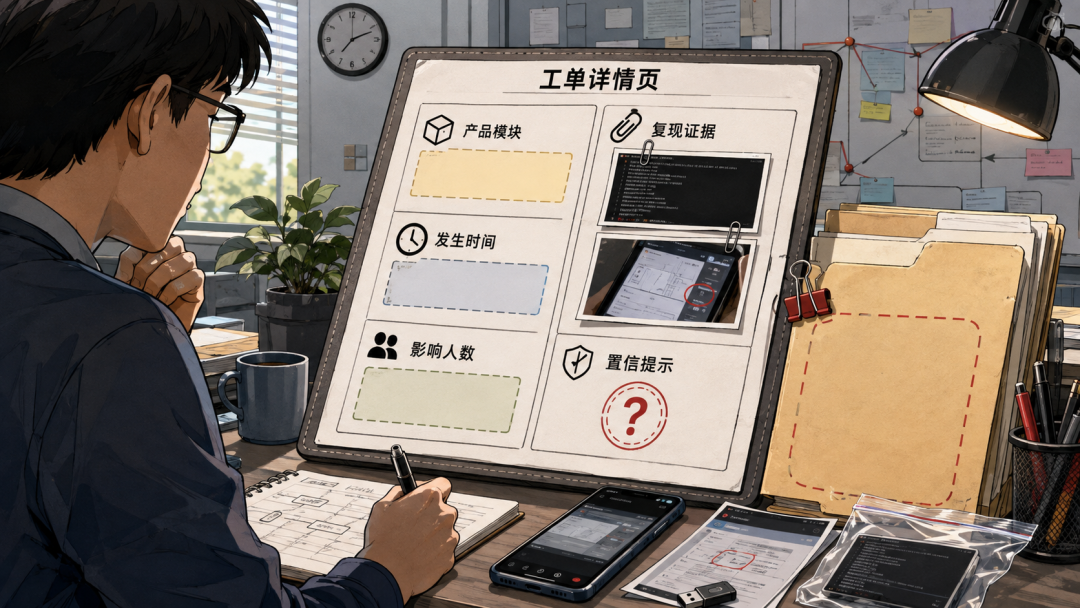
分类之前先把工单变成可比较的业务对象
系统需要提取产品模块、客户环境、发生时间、影响人数、能否绕过、是否重复出现和已有证据,并把缺失字段明确列出。没有这些对象,分类只能依赖标题语气。多客户聚类时要保护租户与个人信息,关联分析可以使用必要字段,不能让不同客户看到彼此的原始内容。
请求类型也不应只有支持或缺陷两个选项。至少要区分使用咨询、配置问题、数据异常、已知缺陷、新缺陷、安全风险与服务事故,才能把不同责任送往不同路径。模型或标签规则更新后,应回放一组历史重大事故与普通咨询,确认漏升级率没有因为追求自动化而上升。
AI给出的标签必须附带依据片段和置信提示。模型从哪句话判断影响范围,哪些关键信息仍未确认,接手者应能直接看见,而不是只得到一个结论。相同客户连续提交多张工单时,系统要判断它们是同一事件的补充证据,还是彼此独立的问题,避免重复占用队列。
升级
优先级来自影响证据,不能被客户语气替代
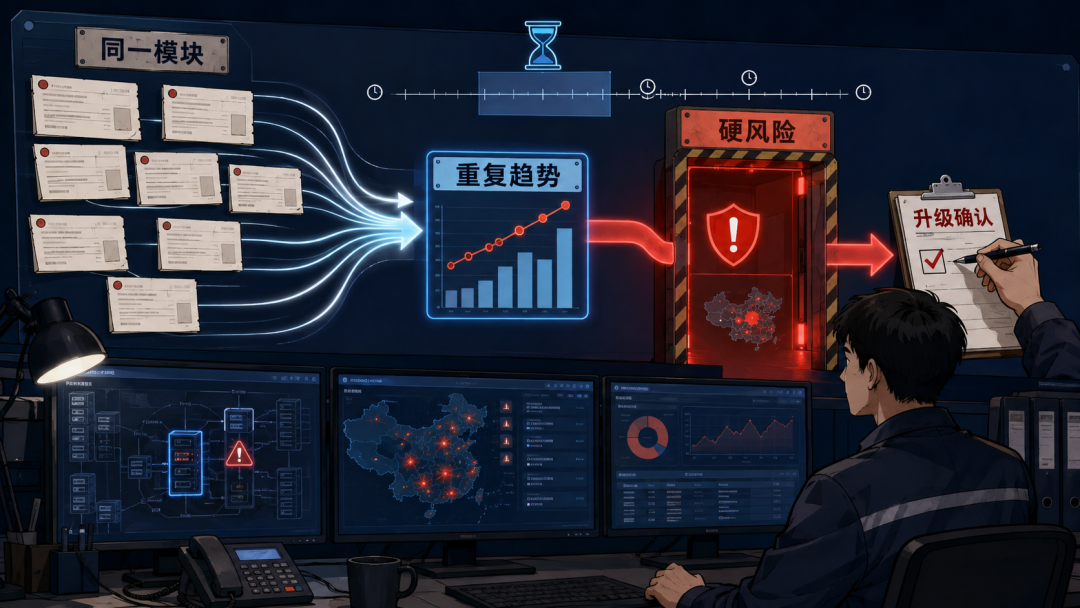
高优先级不等于声音**。系统应综合受影响客户数、核心功能中断、数据或资金风险、是否存在替代路径、持续时间和重复趋势,再建议严重程度。值班人员收到升级通知后应明确确认接管,只有消息送达而没有责任人领取,事故仍停留在信息层。
当多张低信息工单指向同一模块、同一版本或同一时段,聚类信号本身就值得升级。单张请求看起来轻微,合在一起可能已经是一场正在形成的事故。团队还应观察哪些模块持续产生低质量工单,这可能意味着产品提示、监控或提交入口本身需要改造。
涉及安全、资金、数据完整性或大范围不可用时,规则应覆盖模型分数,直接通知值班负责人。AI可以帮助发现关联,不能自行压低硬风险。客服补充的信息应保留来源和时间,不能把推测写成客户确认事实,否则工程排查会沿着错误前提展开。
接管
升级动作要把复现上下文一起交给责任人
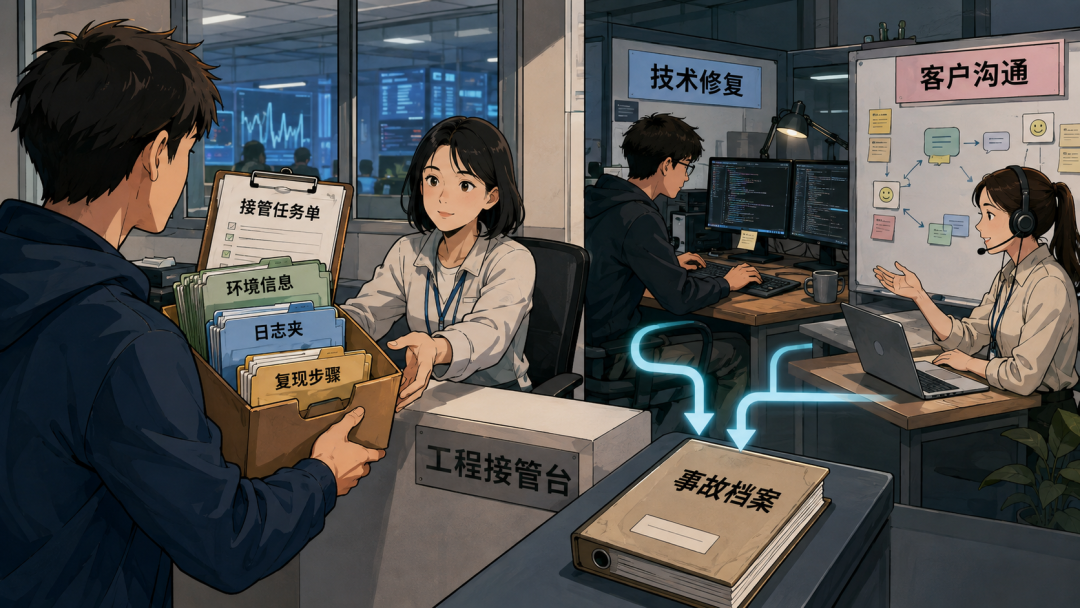
分诊完成不等于问题被接住。转给工程团队时,应同时携带环境、时间线、日志位置、复现步骤、相关客户和已尝试动作,减少下一轮从头询问。无法复现的请求也要有明确去向:是补采证据、交由客服继续确认,还是进入观察队列等待相似信号。
反复退回不能成为默认工作方式。补采日志要遵守最小权限与留存期限,排障便利不能成为长期复制敏感数据的理由。重大事故触发后,还需创建指挥角色、更新时间和客户沟通任务。
技术修复与外部解释沿两条线推进,最终在同一事故记录里汇合。版本号、区域和最近发布记录应自动带入工单,让工程师先看到变化背景,再决定是否需要回滚或扩大调查。
校准
人工改写不是返工,而是分诊系统的训练材料
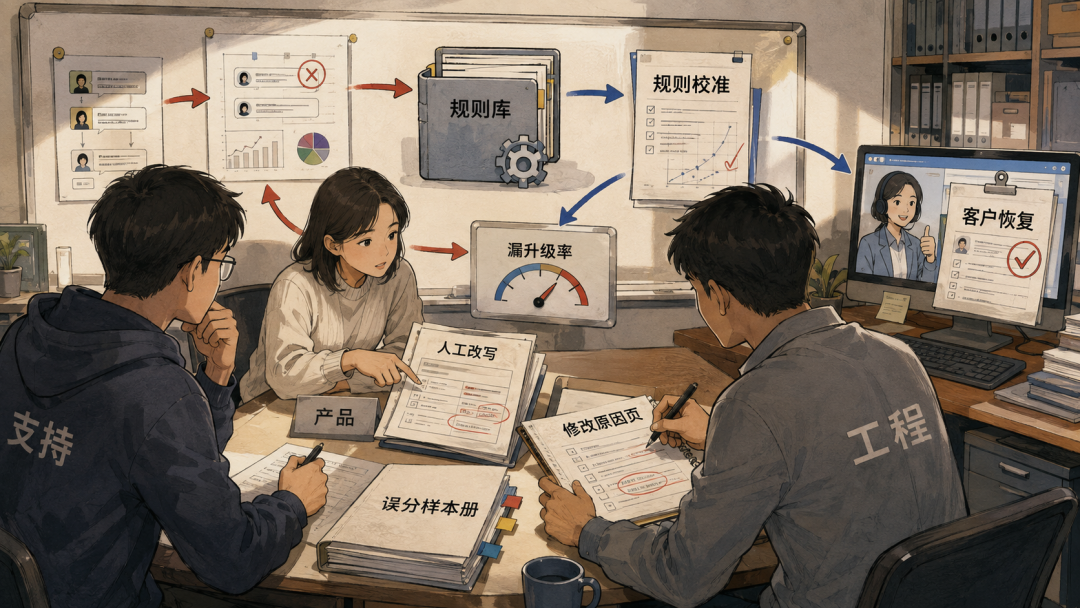
人工接受、修改或推翻分类时,应记录原因。是请求描述不足、产品知识过期、规则遗漏,还是模型误读影响范围,不同原因对应不同修复动作。案例中的75%抽检准确率适合成为起点,不应被包装成自动放行依据。
团队可以按风险分层,高置信低风险请求自动路由,高影响与低置信请求持续人工复核。高频修改项应进入每周复盘,由支持、产品和工程共同更新标签定义、提问模板与已知问题。分类能力属于跨团队资产,不能只交给模型维护。
复查
工单变少不代表变好,验收要回到客户恢复
管理层可追踪首次路由正确率、补证往返次数、重大事故漏升级率、工程接管时长、人工改写率和客户恢复时间,避免只用自动分类数量证明效率。当客服能够通过明确步骤解决问题时,系统应把动作与结果记录下来,为下一次相似请求提供经过验证的路径。
如果工单更快被关闭,客户却反复提交同一问题,说明系统优化了队列外观,没有解决真实故障。分诊结果必须与修复、知识更新和客户确认关联。成熟的AI分诊不会隐藏不确定性。
它让普通请求少走弯路,让高风险信号更早被看见,也让每次人工判断都能修正下一轮升级链路。已知问题匹配成功时,也要检查适用版本和解决状态,历史相似不能直接证明当前请求已经有答案。

编辑:丁帆
审核:董晓龙
本文章由烁域科技原创出品,版权归属烁域科技所有。部分图片为原创配图资产,如有版权问题,请联系公众号客服。