二手车平台把智能体错误从每8次1次降到每50次1次,问题发现由数小时缩到数分钟;一条持续评测链开始接管上线质量
运行诊断 · 智能体评测
核心判断:智能体的生产质量来自“构建期评测、发布闸门、线上监控、失败回流”四件事连续运行;一次回答正确,只能证明一次结果,不能证明系统可靠。
错误率 工具调用 质量闸门 线上采样 失败回流
英国二手车平台Motorway每天组织拍卖,最多约8000名经销商竞拍约2500辆汽车。平台用智能体把原本需要数小时的人工筛选,改成经销商可以直接用自然语言提出库存条件。场景看起来很适合AI:用户说车型、车龄、能源类型与价格,系统调用搜索工具并返回车辆。
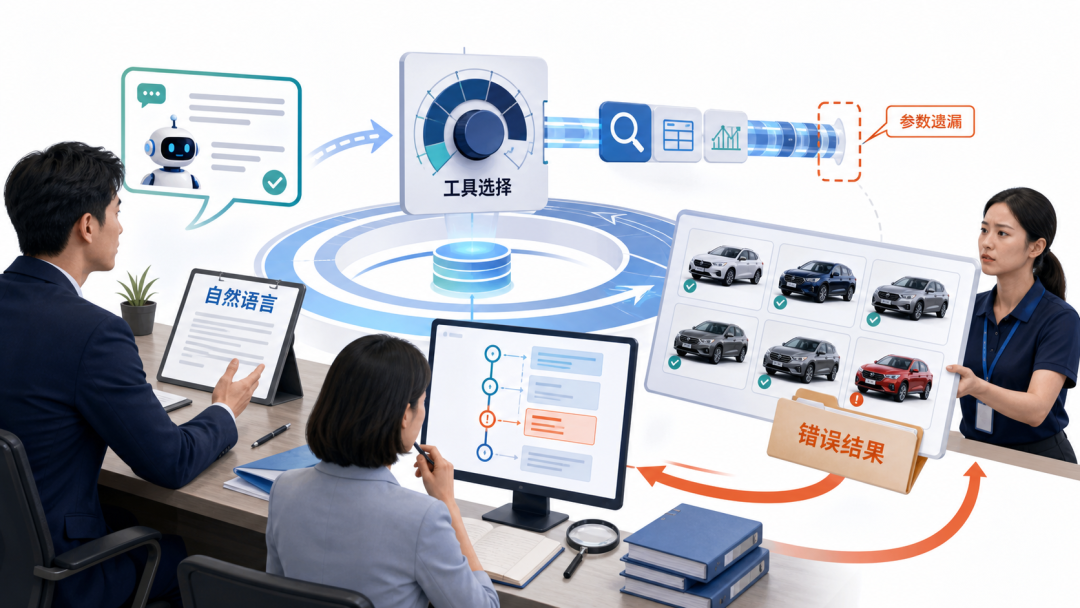
但真实问题藏在流畅回答后面,工具选错、参数漏掉、语义误解和多轮对话漂移都可能给出看似合理的错误结果。AWS与Motorway在2026年7月23日公开的案例称,端到端评测管线把错误结果从约每8次出现1次降到约每50次1次,问题发现时间也由数小时缩短到数分钟。
这是特定案例结果,不应直接外推为所有智能体的通用收益。更值得企业拆解的,是数字背后的质量机制:构建期先测工具、推理与输出,发布前设置阈值,生产流量持续抽样,真实失败再变成新测试。智能体因此不再只靠上线前演示获得信任。
症状
流畅回答会掩盖执行错误
传统软件测试常把输入与确定输出逐项比对,智能体却可能在同一句问题上走出不同工具路径。它说得自然,不代表筛选条件已经完整传给系统,更不代表返回对象符合业务约束。例如“汽油、混动和电动车,车龄不超过五年”包含多个并列条件;
“想找一辆旧一点的大众”又需要理解口语。若只看最终文字,团队很难知道错误出在意图、参数、搜索还是总结。对失败案例的人工标注需要统一标准,什么算错误车辆、无帮助回答和严重风险必须写清,避免评测者各自理解。这类故障最消耗效率的地方,
是它们往往不触发系统报错。经销商得到结果后才发现车辆不合适,运营人员再回查日志,质量成本便从开发阶段转移到真实交易。搜索智能体还要记录未命中原因,区分市场确实没有车辆、筛选条件过窄,还是工具没有正确执行。不同原因对应完全不同的产品动作。
错因
单次测试无法证明稳定可靠
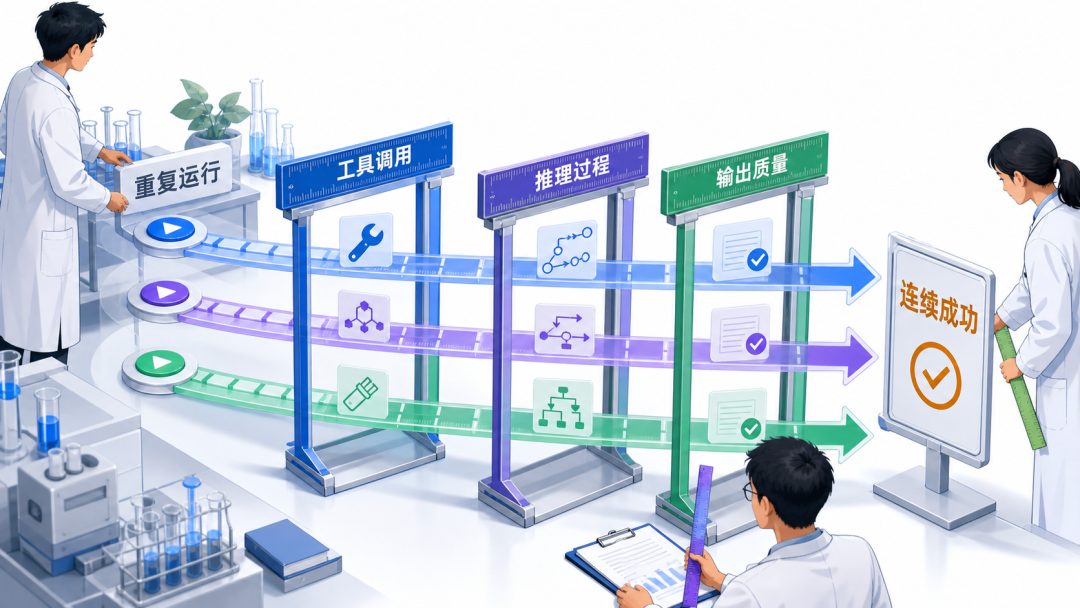
生成结果具有非确定性,同一问题答对一次,只说明这次轨迹没有出错。若企业用十道固定题人工试跑,然后把“看起来都对”当作上线依据,偶发失败和连续任务中的漂移很容易漏过。案例提出用pass^k观察连续成功概率。假设单次成功率为75%,
连续三次都成功的概率只有约42%。业务需要稳定重复时,平均分和一次漂亮演示都会高估真实可靠性。指标面板应同时显示质量、延迟和调用成本,某个版本即便更准确,如果每次任务需要大量无效工具调用,也未必适合生产。
因此测试集要覆盖标准表达、口语变体、多轮追问、边界条件和异常工具返回,并对相同任务重复运行。稳定性必须被测量,而不是由团队印象补足。对自然语言中的否定、区间和并列条件,应建立专门样本,因为这些表达最容易在参数转换时丢失或被错误合并。
三层
工具、推理和输出要分别验收
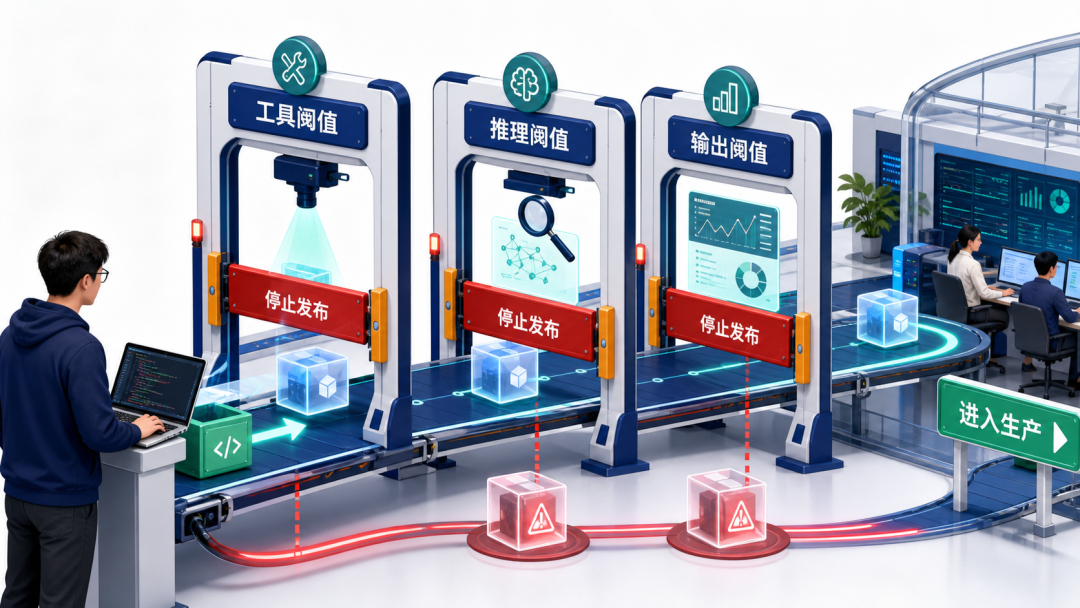
Motorway案例把评测拆成三层。**层检查工具选择与参数传递,阈值高于95%;第二层检查推理与决策过程,阈值高于85%;第三层检查回答的帮助性与准确性,阈值高于90%。测试集不能只由开发者编写,运营和经销商的真实说法能够补上技术团队不熟悉的缩写、俗称与业务习惯。
三层分开后,团队才能定位修复对象。工具调用不合格,应修改路由、参数约束或数据接口;推理不稳定,要调整任务分解与上下文;输出不清楚,则处理表达与证据呈现。企业不必机械复制同一阈值,但必须按业务后果确定自己的合格线。
涉及报价、库存承诺和交易动作的任务,应比内部资料整理拥有更严格的工具与结果要求。生产监控发现某类错误集中出现时,可以临时收窄智能体能力或增加确认步骤,先保护交易结果,再安排长期修复。
闸门
发布流程必须允许质量阻断
评测只有能阻断发布才会成为治理机制。案例使用五阶段部署管线,当工具、推理或输出指标低于阈值时停止推进,避免团队在已知质量不足的情况下依旧把版本推向生产。闸门需要记录测试集版本、模型与提示版本、工具接口、指标结果和批准人。
否则一次通过无法解释下次退化,也无法判断变化来自模型、数据、代码还是业务规则。在线评测器本身也会出错,关键样本应保留人工复核与校准,防止团队把一个新的模型评分当成绝对事实。对企业而言,质量闸门不是多一道形式审批,
而是把“可以上线”的判断从会议意见变成证据。只有失败条件写清,速度和质量才能在同一条流水线上协商。如果用户连续修改条件,评测还要检查旧条件是否被正确保留或删除,避免上下文残留把上一轮约束带进新查询。
监控
生产流量要持续揭示新问题
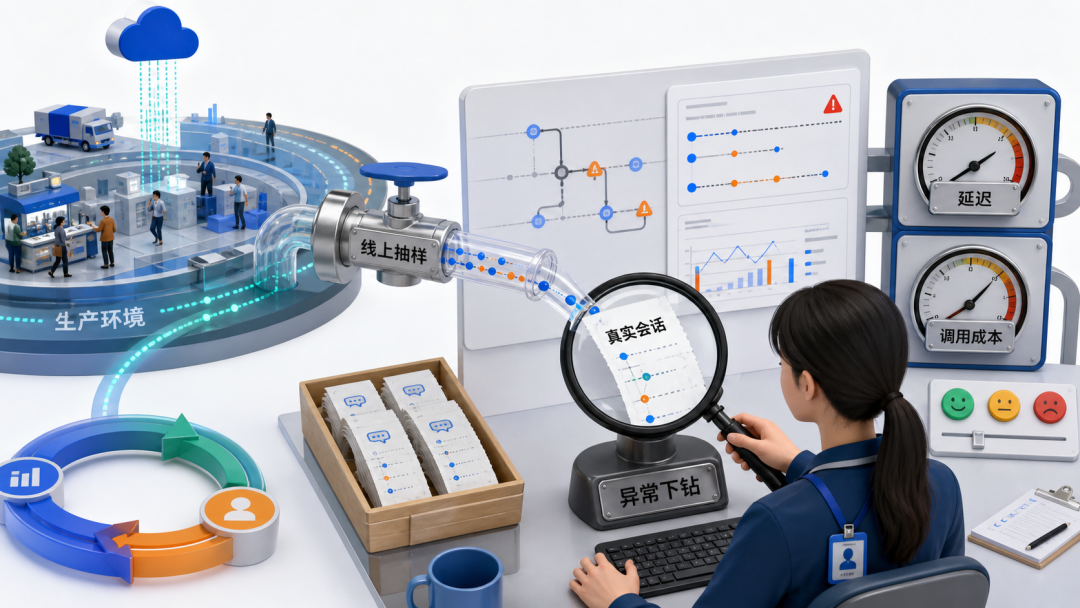
上线前测试无法覆盖所有用户语言、稀有车型、超时和接口波动。案例在生产环境使用在线评测与按需评测,并建议从约1%的流量抽样开始,再根据成本和风险逐步调整。线上评测要关联具体会话、工具轨迹、延迟、结果与用户反馈。出现异常时,
团队可以从聚合指标下钻到一次执行,判断这是孤立输入、系统退化还是某类规则长期失效。抽样比例并非越高越好。低风险任务可关注趋势,高风险动作需要更密集监控或人工确认;评测成本也应进入运营账,避免质量系统本身失去经济性。
闭环
让真实失败扩充下一轮测试
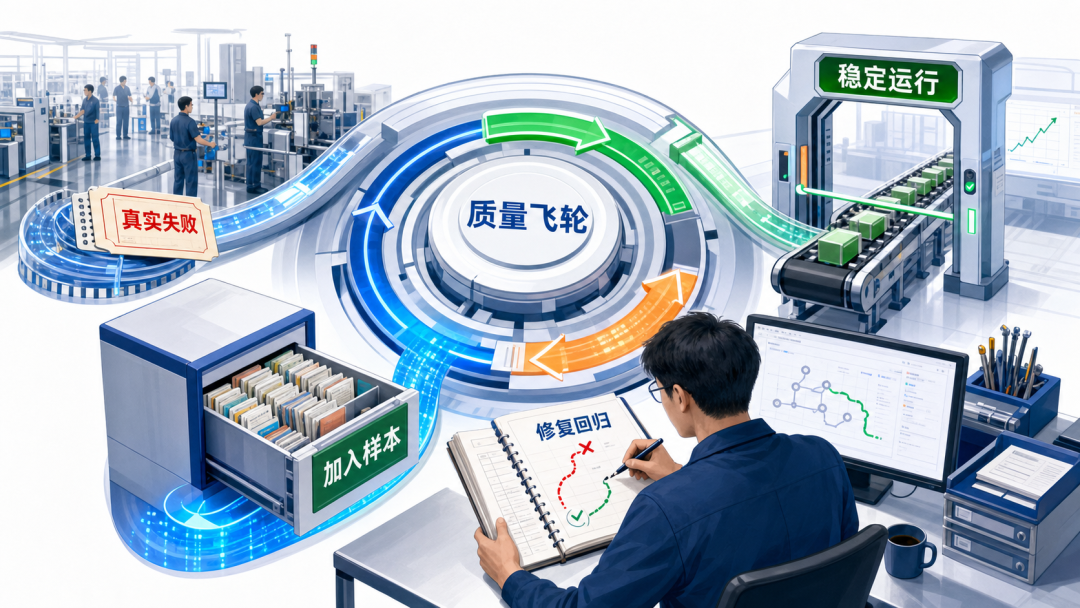
最有价值的线上失败不是一条投诉,而是一道新测试题。团队把真实表达、错误轨迹、正确结果和修复版本沉淀到测试集,下一次发布便会自动检查同类问题是否再次出现。质量闸门要区分必须阻断的核心指标和仅作提醒的趋势指标,
避免所有轻微波动都让发布流程失去节奏。这使评测从项目交付物变成持续资产。版本越多,测试集越能代表真实业务;指标也从笼统准确率,逐步扩展到连续成功、工具成本、响应时间和异常恢复。每次模型或搜索接口更新后,
应先跑回归样本再进入影子流量,确认旧能力没有因为局部优化而退化。Motorway案例说明,智能体提效不只发生在用户搜索的一刻。企业真正修复的是发现错误、定位原因和阻断退化的速度;当质量链能够持续运行,智能体才有资格承接更高价值动作。

编辑:丁帆
审核:董晓龙
本文章由烁域科技原创出品,版权归属烁域科技所有。部分图片为原创配图资产,如有版权问题,请联系公众号客服。